昇騰(Ascend)AIプロセッサ向けの算子開発フレームワークであるCANN/asc-devkitにおいて、CubeResGroupHandleはAIコアの計算リソースを分離モードで論理的に分割し、管理するための中枢インターフェースです。本仕組みは、ベクトル演算コア(AIV)をクライアント側、キューブ演算コア(AIC)をサーバー側とするクライアントサーバーアーキテクチャを採用しています。AIVは個別の計算タスクをメッセージとしてキューに投入し、AICはキューをポーリングしてメッセージの種別と内容を解析し、該当する演算ルーチンを呼び出します。1つのグループハンドル内に複数のAICを配置可能ですが、各AICは単一のハンドルにのみ所属可能である一方、AIVは複数のハンドルに跨がって割り当てることが技術的に許可されています。
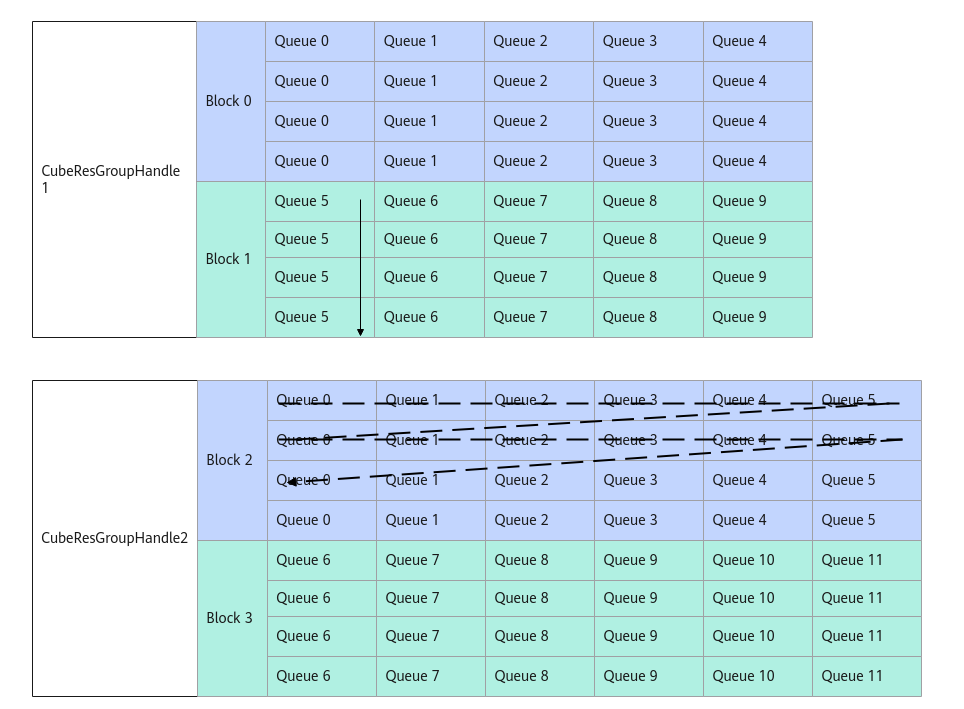
上述の図に示すように、1つのグループハンドル配下には複数のAICと多数のAIVが配置され、それぞれ固有のメッセージキューと対になります。キューの深さは固定(例:最大4メッセージ)であり、AIVはキューにメッセージをプッシュします。AICはキューを巡回してタスクを消費します。グループ間のメッセージ処理順序は、キューのインデックス順またはハンドルが定義するルーティング規則に従います。
本機能を実装するための標準的な手順は以下の通りです。以下のコード例では、フレームワークのAPI仕様は維持しつつ、変数名・構造体名・制御フローを再構築し、可読性と独立性を高めています。
- 計算オブジェクトの型定義
ユーザーはAIC上で実行する演算のデータ型と設定をテンプレート引数として指定します。例として行列積(Matmul)演算を定義する場合:// 実際の演算データ型と正規化フラグに合わせてカスタマイズ using ComputeCoreType = MatmulImpl - 通信領域管理オブジェクトの初期化
KfcWorkspace相当のオブジェクトを用いて、AIVとAICが共有するグローバルメモリ上のメッセージ配送エリアを予約します。ハンドル生成前にベースアドレスのメモリ領域をクリアしておく必要があります。CommAreaManager commDesc(globalMemBaseAddr); - メッセージペイロードの設計
AIVからAICへ渡すタスク定義用の構造体を定義します。ハードウェア要件により、構造体サイズは64バイトアライメントを満たす必要があります。また、配送メカニズムが正しく動作するために、先頭に2バイトのヘッダーを必ず配置します。フィールド名 役割 TaskPayloadユーザー定義のメッセージ本体。64B境界に配置。先頭にヘッダー必須。 struct TaskPayload { MsgHeader hdr; // 2B, 先頭に配置必須 uint8_t taskType; uint8_t skipCount; uint32_t metaValue; bool isTransA; bool isTransB; bool isAtomicOp; bool isFinalBlock; int32_t tailM; int32_t tailN; int32_t tailK; uint64_t addrA; uint64_t addrB; uint64_t addrC; uint64_t strideA; uint64_t strideB; };MsgHeaderキュー内メッセージの制御ステータス。 MsgState::FREE: 未使用領域MsgState::VALID: 有効タスクMsgState::QUIT: 終了通知MsgState::FAKE: ダミータスク(マージ処理用) - コールバックハンドラの構築
AICがメッセージを受信した際に実行される初期化ルーチンとタスク処理ルーチンをテンプレート構造体として実装します。template<class ComputeCoreType, class TaskPayload> struct ExecutionHandler { __aicore__ inline static void Initialize(ExecutionHandler<ComputeCoreType, TaskPayload> &ctx, ComputeCoreType &core, GM_ADDR tilingBase) { // グローバルメモリからティリング情報を転送 auto srcPtr = reinterpret_cast<__gm__ uint32_t*>(tilingBase); auto dstPtr = reinterpret_cast<uint32_t*>(&ctx.tilingCfg); for (int i = 0; i < sizeof(TCubeTiling)/sizeof(uint32_t); ++i, ++srcPtr, ++dstPtr) { *dstPtr = *srcPtr; } core.SetSubBlockIdx(0); core.Init(&ctx.tilingCfg, GetTPipePtr()); } __aicore__ inline static void Execute(ComputeCoreType &core, __gm__ TaskPayload* recvMsg, CubeResGroupHandle<TaskPayload> &hndl) { switch (recvMsg->taskType) { case 0: ProcessRoutine0(core, recvMsg, hndl); break; case 1: ProcessRoutine1(core, recvMsg, hndl); break; default: break; } } template<int32_t id> __aicore__ inline static typename IsEqual<id, 0>::Type ProcessRoutine0(ComputeCoreType &core, __gm__ TaskPayload* msg, CubeResGroupHandle<TaskPayload> &hndl) { GlobalTensor<int64_t> dbgBuf; dbgBuf.SetGlobalBuffer(reinterpret_cast<__gm__ int64_t*>(msg) + 1); DataCacheCleanAndInvalid<int64_t, CacheLine::SINGLE_CACHE_LINE, DcciDst::CACHELINE_OUT>(dbgBuf); int32_t skipCnt = 0; for (int32_t i = 0; i < skipCnt + 1; ++i) { hndl.FreeMessage(msg + i); } hndl.SetSkipMsg(skipCnt); } template<int32_t id> __aicore__ inline static typename IsEqual<id, 1>::Type ProcessRoutine1(ComputeCoreType &core, __gm__ TaskPayload* msg, CubeResGroupHandle<TaskPayload> &hndl) { GlobalTensor<int64_t> dbgBuf; dbgBuf.SetGlobalBuffer(reinterpret_cast<__gm__ int64_t*>(msg) + 1); DataCacheCleanAndInvalid<int64_t, CacheLine::SINGLE_CACHE_LINE, DcciDst::CACHELINE_OUT>(dbgBuf); int32_t skipCnt = 3; hndl.FreeMessage(msg, MsgState::VALID); for (int32_t i = 1; i < skipCnt + 1; ++i) { hndl.FreeMessage(msg + i, MsgState::FAKE); } hndl.SetSkipMsg(skipCnt); } TCubeTiling tilingCfg; }; - グループハンドルの生成
CreateCubeResGroupを呼び出し、指定したブロック範囲とキュー容量でリソースグループを確立します。/* * グループID: 0, 計算型: ComputeCoreType, ハンドラ: ExecutionHandler * ペイロード: TaskPayload, 通信領域: commDesc, 開始ブロック: 0 * ブロック数: 12, キューサイズ: 48, ティリングアドレス: tilingBase */ auto groupHandle = AscendC::CreateCubeResGroup<0, ComputeCoreType, ExecutionHandler, TaskPayload>(commDesc, 0, 12, 48, tilingBase); - AIV(ワーカー)の割り当て
各AIVスレッドに固有のキューインデックスをバインドします。インデックスはグループが確保したキュー総数未満である必要があります。groupHandle.BindWorkerQueue(workerIndex); - タスクの投入と同期
AIV側はキュー領域を確保し、ペイロードを構築して送信します。タスクマージやスキップ処理が必要な場合はダミーメッセージを用います。MsgHeader hdr = {MsgState::VALID, static_cast<uint8_t>(workerIndex)}; TaskPayload msgA {hdr, 0, 0, 0, false, false, false, false, 0, 0, 0, 0, 0, 0, 0, 0}; TaskPayload msgB {hdr, 1, 0, 0, false, false, false, false, 0, 0, 0, 0, 0, 0, 0, 0}; uint32_t queueOffset = 0; if (GetBlockIdx() == 0) { auto taskPtr = groupHandle.template AllocMessage(); queueOffset = groupHandle.template PostMessage(taskPtr, msgB); bool completed = groupHandle.template Wait<true>(queueOffset); } else if (GetBlockIdx() < 4) { auto taskPtr = groupHandle.AllocMessage(); queueOffset = groupHandle.PostFakeMsg(taskPtr); bool completed = groupHandle.template Wait<true>(queueOffset); } else { auto taskPtr = groupHandle.template AllocMessage(); queueOffset = groupHandle.template PostMessage(taskPtr, msgA); bool completed = groupHandle.template Wait<true>(queueOffset); } - 処理系の正常終了
全てのタスク投入が完了した後、各AIVは割り当てられたキューに対して終了通知を送信し、グループから安全にデタッチします。auto exitPtr = groupHandle.AllocMessage(); groupHandle.NotifyExit(exitPtr);